Når man undersøger markedet og overvejer at investere i AI-infrastruktur, hopper de fleste samtaler direkte til specs og priser. Denne artikel starter et skridt tidligere. Med det, der betyder noget, når I beslutter, hvor jeres AI skal køre, og hvorfor den rigtige beslutning er sværere, end den ser ud.
Start med hardwaren og slut med kontrollen
GPU server hosting betyder, at I lejer adgang til servere med GPU'er hos en udbyder i stedet for selv at købe, placere og drifte hardwaren.
Snakken om GPU-serverinfrastruktur starter næsten altid det forkerte sted: specs, priser og benchmarks, før de grundlæggende spørgsmål er besvaret. Hvad binder I jer egentlig til, når I vælger, hvor jeres AI skal køre?
De fleste ender med deres valg, fordi det bare skete, ikke fordi der lå en strategi bag. Det kan være et cloud-API til et proof of concept, delt GPU-hosting eller en managed model, der aldrig var tænkt som en permanent løsning. Når man når dertil, er infrastrukturvalget allerede truffet. Men var det det rigtige?
Laget, der ændrer alt
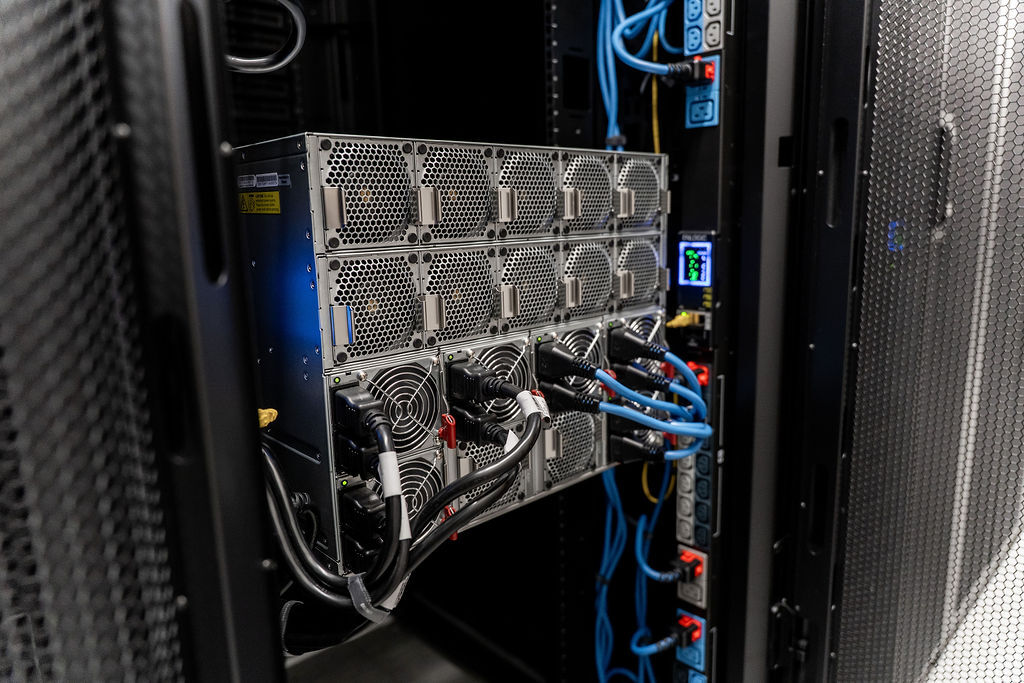
GPU server hosting er ikke bare en hurtigere udgave af almindelig computerkraft. En CPU er bygget til generel databehandling. En GPU er designet til at udføre mange beregninger parallelt. Det er den arkitektur, der gør GPU'er til den rigtige hardware til AI, fx træning og inferens af sprogmodeller: den slags beregninger, som CPU-baseret infrastruktur ikke kan matche.
Når det gælder AI-workloads, er det GPU'en, der gør arbejdet, og NVIDIA er fortsat det foretrukne valg i større virksomheder.
Hvad er det egentlig, I vælger imellem?
Den type GPU server hosting, der passer til jer, afhænger af, hvor I er på jeres AI-rejse. Valget mellem cloud og dedikerede GPU'er bliver tit set som et spørgsmål om pris. Et mere nyttigt spørgsmål er: Hvor meget kontrol har jeres workload brug for?
-
Cloud-GPU-hosting: Hvis I er ved at finde ud af, om et workload overhovedet holder, får I on-demand-adgang, ingen hardware at administrere, og I betaler kun for det, I bruger. Bagsiden er, at ressourcerne er delte, og at omkostningerne stiger hurtigt, når workloadet bliver permanent.
-
Dedikeret GPU: Når workloadet er på plads og kører konstant, har I brug for en dedikeret model. I får eksklusiv adgang til GPU'en uden andre lejere på samme hardware. Det er her, seriøs AI kører. I styrer selv miljøet, eller vi driver det for jer.
Det, de fleste evalueringer overser: Delte GPU-miljøer kører ofte med oversubscription, hvor der bliver lovet mere virtuel kapacitet, end hardwaren kan levere. For AI, der kører konstant, betyder det, at jeres output falder, når en anden lejer på samme hardware topper. Det står ikke i noget datablad.
Dedikeret infrastruktur giver jer hardwarens fulde kapacitet. Her er en enkel måde at se, hvilken løsning der passer:
| Faktor | Delt GPU | Dedikeret GPU |
|---|---|---|
| Stabil performance | Varierende: afhænger af andre lejeres forbrug | Stabil: hardwarens fulde kapacitet er reserveret |
| Oversubscription | Almindeligt: ressourcerne bliver delt | Ingen: den fysiske tildeling ligger fast |
| Prismodel | Lavere startomkostninger, betal efter forbrug | Højere grundpris, forudsigelig i stor skala |
| Overblik over governance | Begrænset: delt miljø | Fuldt: I ved, hvad der kører hvor |
| Passer bedst til | Eksperimenter, varierende workloads, R&D | AI i produktion, længerevarende træning, HPC, compliancefølsom brug |
Derfor kan en infrastrukturbeslutning blive dyr
De fleste udbydere taler om at skalere AI, men færre taler om, hvad der ændrer sig, når den kører i produktion: Hvor bliver data behandlet, hvem styrer miljøet, og hvad sker der, når performance falder under reel belastning? Der er fire ting, I skal have skarpt for øje:
-
Performance bliver et krav. Delt GPU-infrastruktur bygger på en antagelse om, at ikke alle lejere topper samtidig. Når jeres workload kører konstant, holder antagelsen ikke. Ustabil performance i produktion er en driftsrisiko, ikke et teknisk irritationsmoment.
-
Data governance er ikke længere teori. I et delt miljø kan I formulere en datapolitik. Det, I ikke altid kan kontrollere, er, hvor data faktisk ender, og hvem der kan få adgang. I produktion kan den sikkerhed ikke komme fra et dokument. Den skal komme fra selve infrastrukturen.
-
Omkostninger bliver en prognose, ikke et gæt. Betaling efter forbrug giver mening, når forbruget er uforudsigeligt. Når AI kører konstant, skaber variable omkostninger usikkerhed. Dedikeret kapacitet bytter fleksibilitet for forudsigelighed, og for workloads der kører hele tiden, er det den bedste byttehandel.
-
Afhængigheden bliver synlig. Et managed API er praktisk, indtil priserne ændrer sig, en model udfases, eller vilkårene ændres på en måde, der rammer jer. Når AI er et sideprojekt, er afhængigheden nem at ignorere. Når hele driften kører på den, er den ikke.
Jeres data skal ligge et sted. Sørg for, at I ved hvor.
De fleste behandler dataresidens som et juridisk flueben. Men hvor jeres data bliver behandlet, på hvilke servere og under hvilken jurisdiktion, afgør, hvilken governance I reelt kan stå inde for.
Læs: En guide til suveræn AI: Hvem har kontrollen over den AI, jeres virksomhed kører på? →
Før I binder jer: de spørgsmål, der virkelig betyder noget
Evalueringer af GPU-infrastruktur går typisk i stå ved specs: hvilken NVIDIA-generation, hvor meget hukommelse, hvilken netværksbåndbredde. Det er vigtigt, men de beslutninger, der afgør, hvor godt infrastrukturen tjener jer de næste to år, er sjældent tekniske.
Her er de spørgsmål, seriøse købere stiller, og som vi hos ScanNet kan svare direkte på:
Dedikeret eller delt GPU?
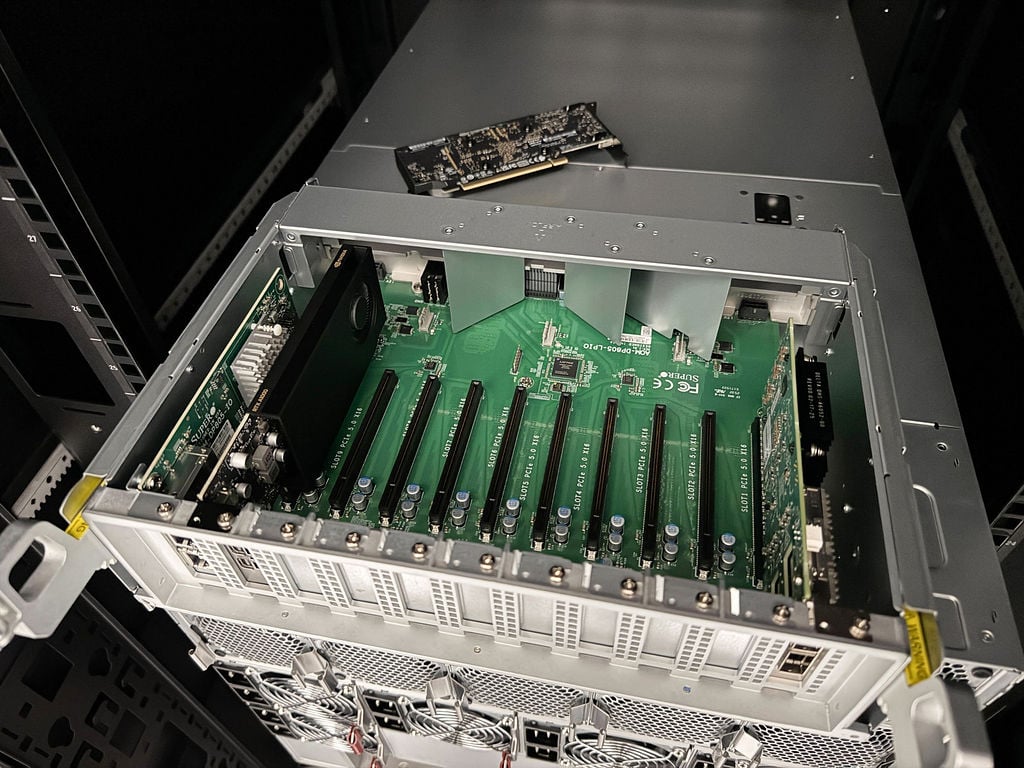
Alle ScanNets GPU-servere er dedikerede. GPU'en er koblet til jeres virtuelle server via PCI passthrough, så hele kortet er jeres alene. CPU-kernerne er jeres egne: 4 til 64 dedikerede vCPU-kerner, tildelt 1:1 uden oversubscription. I kan have fra 1 til 8 GPU'er pr. server.
Hvilken hardware er tilgængelig?
ScanNet dækker hele AI-livscyklussen hos én udbyder, fra test og udvikling til inferens af frontier-modeller:
-
NVIDIA L4: test og batch-opgaver, hvor kravene til token/sek. og modelstørrelse er begrænsede.
-
NVIDIA L40S: inferens, 3D-rendering og generativ AI med høj throughput.
-
NVIDIA H100 NVL: stor hukommelse og høj båndbredde til træning af store sprogmodeller og HPC-workloads.
-
NVIDIA RTX 4500, 5000 & 6000 Pro: kører mange af de nyeste open-weight LLM'er i en hastighed, der er egnet til 1-2 udviklere, der arbejder samtidigt.
-
NVIDIA B200 og B300: topydelse og stor hukommelseskapacitet til frontier-modeller med mange samtidige brugere. Kan kobles sammen og understøtte modeller over 1T parametre.
Hver server kan have op til 2.048 GB RAM og 8.000 GB lokal NVMe-storage.
Læs mere og se priser →
Hvor ligger datacentrene?
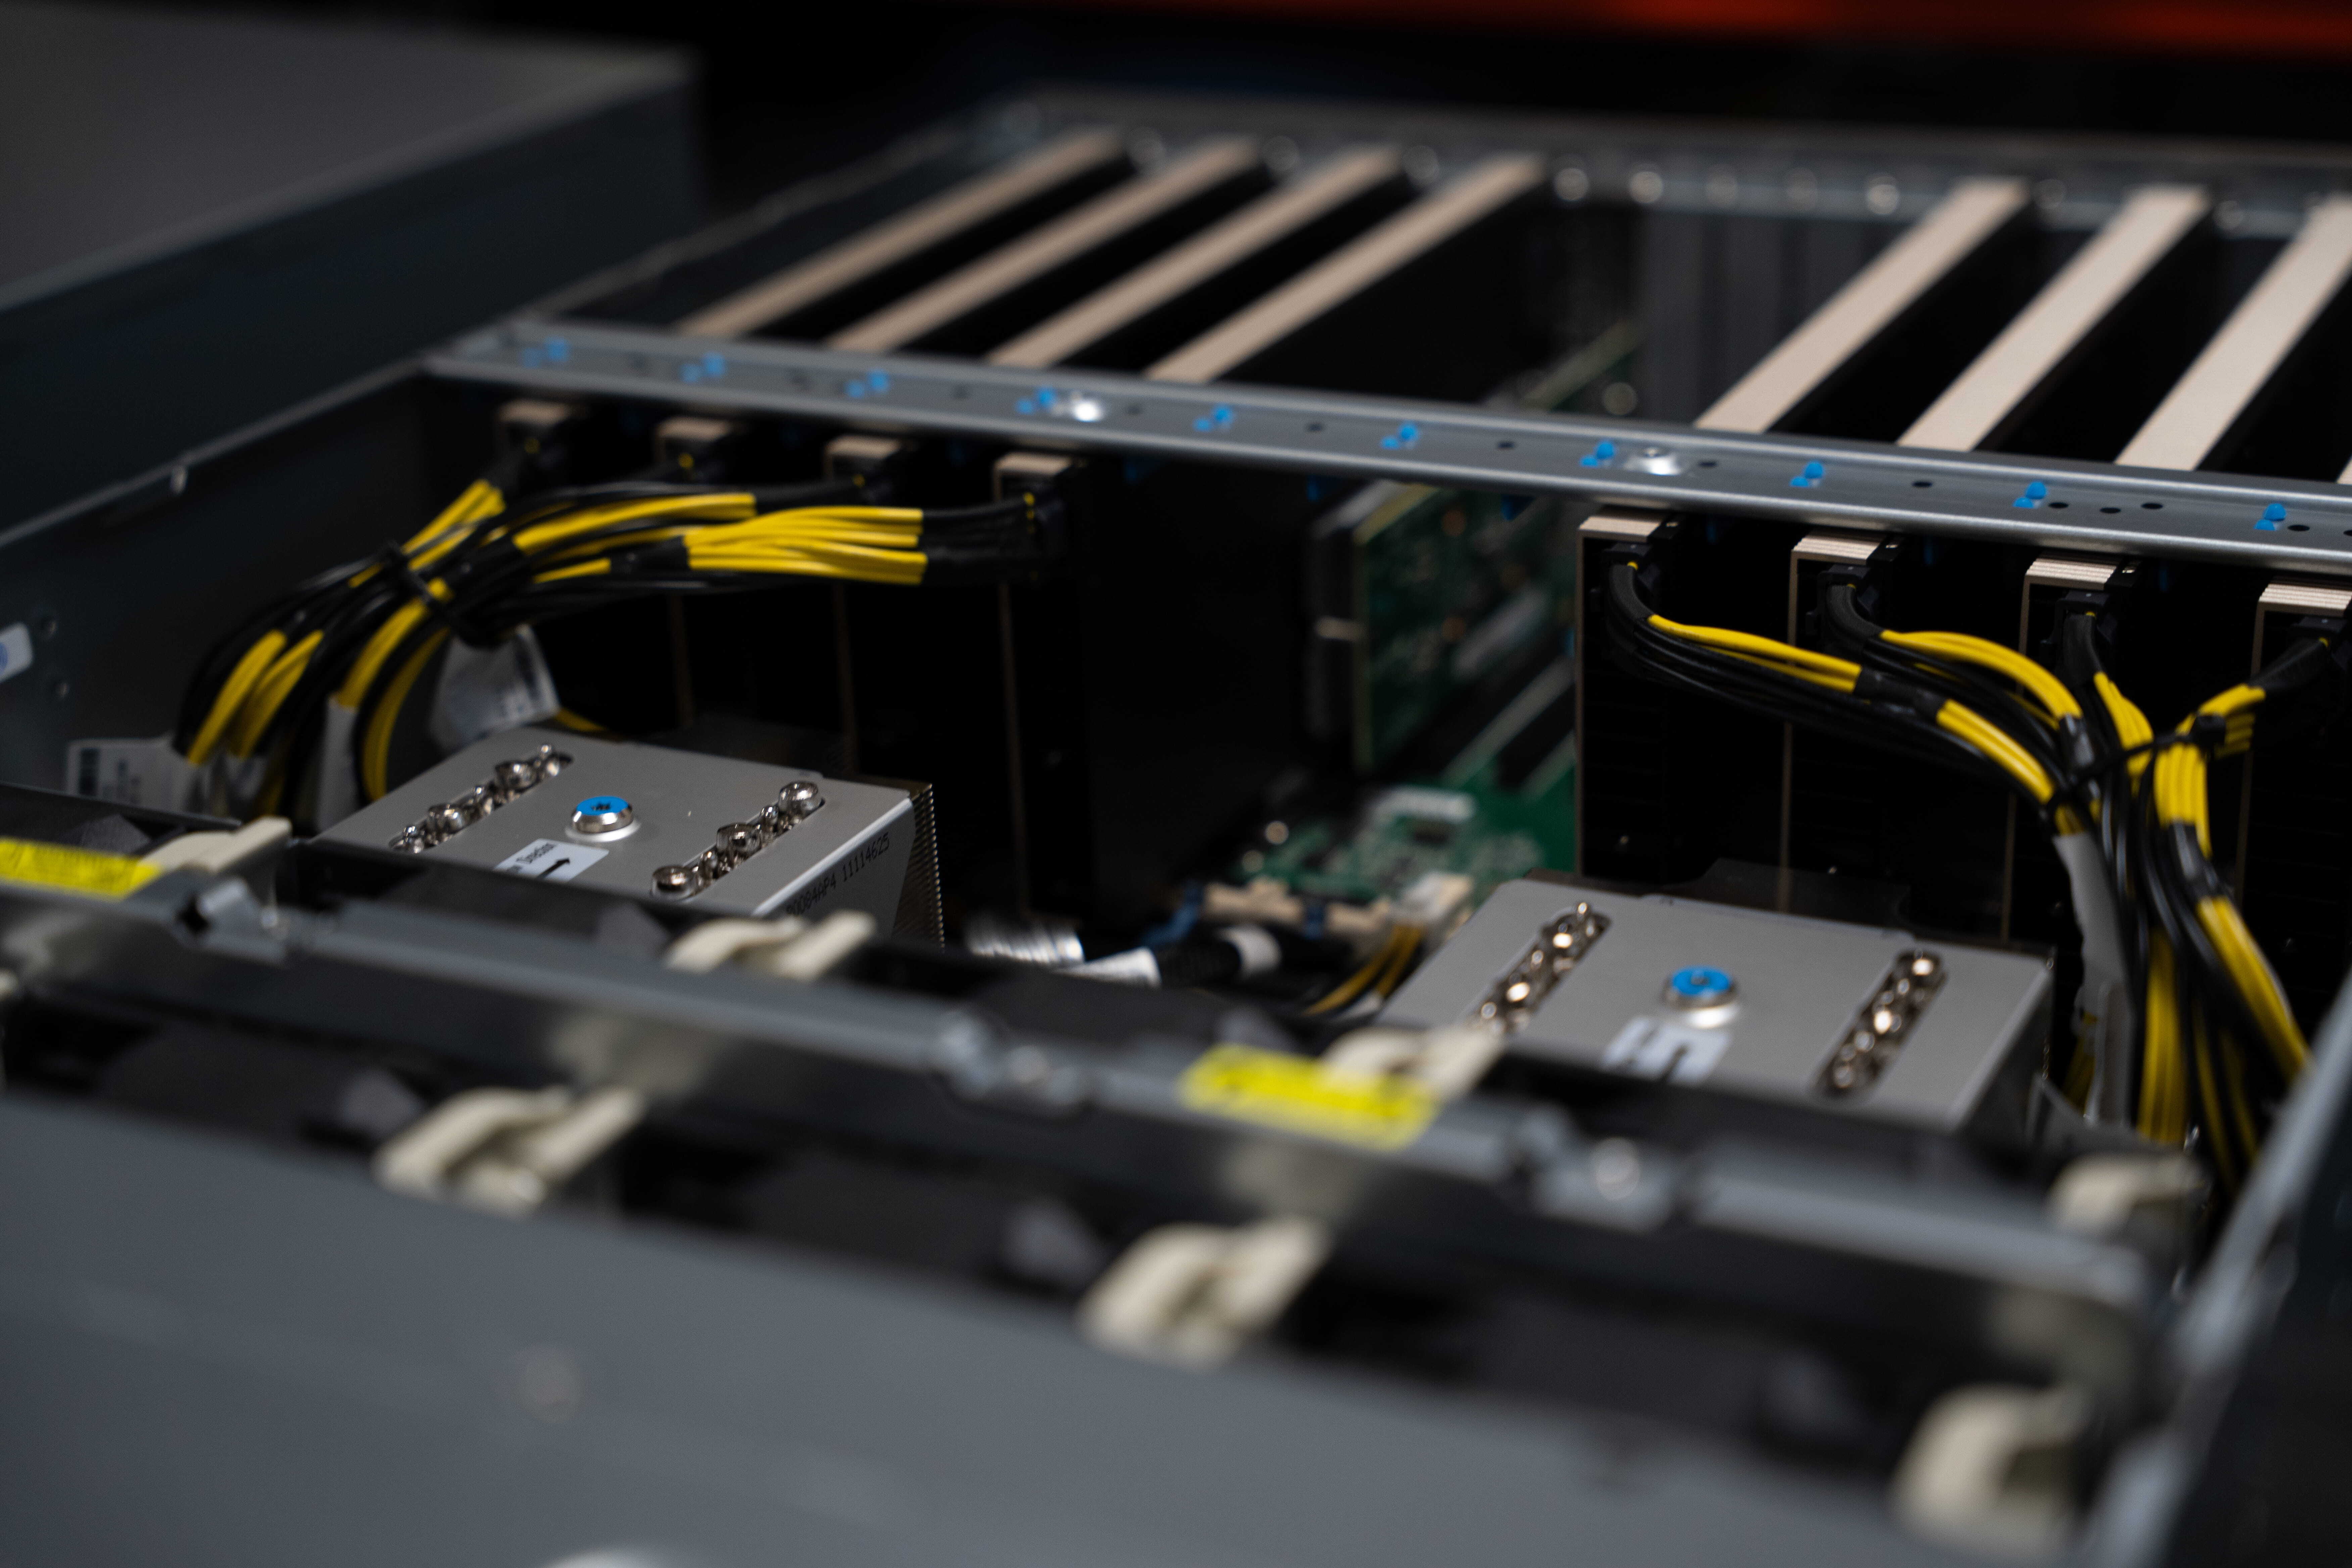
ScanNet driver GPU-serverne i egne danske datacentre, som er ISO 27001-certificerede og revideret efter ISAE 3402 type 2 og ISAE 3000 type 2. Jeres trænings- og inferensdata forlader ikke Danmark. Læs mere om vores datacentre eller compliance.
Hvilke bindingsperioder er der?
Uden binding, eller med 1, 12, 24 eller 36 måneders binding. I kan starte uden at binde jer, mens workloadet valideres, og skifte til en længere periode, når det kører stabilt.
Hvem har adgang til jeres miljø?
I får adgang via SSH med root credentials (Windows: Remote Desktop eller PowerShell). Hosting sker i ScanNets egne datacentre, uden tredjepart. Storage er lokal NVMe.
Hvordan er supporten skruet sammen?
Personlig dansk rådgivning og teknisk sparring, døgnet rundt, året rundt. I kan drifte miljøet selv, eller vælge et managed setup, hvor ScanNet driver det for jer.
Hvordan foregår et exit?
Jeres workloads kører på almindelige virtuelle servere med standardoperativsystemer (AlmaLinux, Ubuntu, Windows 11 og Windows Server 2022/2025) og root-adgang. Der er ingen proprietære services at flytte væk fra. Opsigelsesvilkår afhænger af den valgte bindingsperiode.
I sidste ende er de organisationer, der får deres GPU-infrastruktur på plads, ikke nødvendigvis dem med de største budgetter eller de mest tekniske teams. Det er dem, der stillede de rigtige spørgsmål, før de bandt sig.
Uanset om det handler om kontrol, jurisdiktion eller hvad der sker, når kravene ændrer sig, er den rigtige udbyder den, der kan svare klart på de spørgsmål uden at henvise til en salgspræsentation.
Klar til en snak om GPU server hosting?
Uanset om I kører jeres første AI-workload eller skalerer et eksisterende, kan ScanNet guide jer til den løsning, der passer til, hvor I er nu. Se ScanNets GPU-modeller og specifikationer, eller book en snak direkte.
Book 20 minutter med en specialist →